Figma und KI-Agenten: Automatisierte Workflows von der Idee bis zum Code
 Von: Jonas
KI-Agenten in Kombination mit Figma werden entweder dafür eingesetzt, das Design-Team bei der Gestaltung von Layouts und Prototypen innerhalb von Figma zu unterstützen oder um fertige Design-Dateien und Flows in möglichst sauberen und konsistenten Code zu überführen. Grundlage für beides ist eine sauber aufgebaute und inhaltlich detailliert beschriebene Komponenten-Bibliothek.
KI verändert rasant, wie Design und Entwicklung zusammenarbeiten. Für viele Unternehmen und Team-Leads stellt sich daher die Frage, was mit einem Design-Tool wie Figma und einem KI-Agenten heute überhaupt möglich ist und welche Voraussetzungen dafür geschaffen werden müssen. Wir geben einen Überblick.
Das Design System als Ausgangspunkt
Grob lassen sich verschiedene Anwendungsfälle unterscheiden. Im ersten sollen Design-Teams innerhalb von Figma durch KI unterstützt und beschleunigt werden. Im zweiten soll das, was in Figma entstanden ist, möglichst schnell und zuverlässig mittels KI in produktionsreifen Code überführt werden.
Egal welchen Weg ihr einschlagt, im Zentrum steht mindestens eine gut gepflegte Figma-Komponenten-Bibliothek, im besten Fall ein echtes Design System, das Design-Komponenten, Code Komponenten, sowie zahlreiche Regeln zur Verwendung der Elemente inkl. Sprachregelungen usw. umfasst. Ein solches System ist der Ort, an dem das gesammelte Wissen des Teams verschriftlicht ist. Je vollständiger und sauberer, desto besser sind die Ergebnisse, die eine KI daraus ableiten kann.
Eine Figma- oder Code-Bibliothek existiert in vielen Unternehmen bereits oder wird gerade aufgebaut. In der Praxis liegt sie allerdings häufig nicht in der Qualität vor, die für KI-Workflows nötig ist. Das betrifft weniger die visuelle Seite als die inhaltlichen und konzeptionellen Aspekte. Oft fehlt zum Beispiel eine saubere Beschreibung des Zwecks einer Komponente, ihrer Einsatzsituationen und ihrer Rahmenbedingungen. Genau dieses Wissen aber braucht die KI, um sinnvolle Entscheidungen treffen zu können.
KI als Unterstützung im Design
Design-Teams, die bereits in Figma arbeiten, können durch KI direkt in Figma unterstützt werden. Es gibt dafür z.B. in Figma integrierte kleinere KI-Funktionen zum Aufräumen der Datei oder zum Erzeugen und Bearbeiten von Bildern. Ihr Zweck ist es in erster Linie, das Team im Arbeitsablauf zu beschleunigen, wiederkehrende Aufgaben abzunehmen, für Konsistenz zu sorgen und Fehler zu vermeiden.
Auch Agenten können für solche Aufgaben eingesetzt werden, doch normalerweise kommen Agenten für komplexere und größere Aufgaben zum Einsatz. Daher gehen wir auf die integrierten KI Mini-Tools hier nicht im Detail ein.
Von der Idee zum Design
Interessant wird es, wenn Konzeption und Prototyping selbst weitgehend selbstständig, also agentisch, erledigt werden sollen. Ziel ist das Erstellen von Screens in einem professionellen, markentreuen und konsistenten Look; möglicherweise sollen sogar klickbare Prototypen entstehen. Dafür braucht es zwingend eine Bibliothek mit allen benötigten Komponenten. Und diese Komponenten müssen nicht nur existieren, sondern vor allem inhaltlich gut beschrieben und organisiert sein.
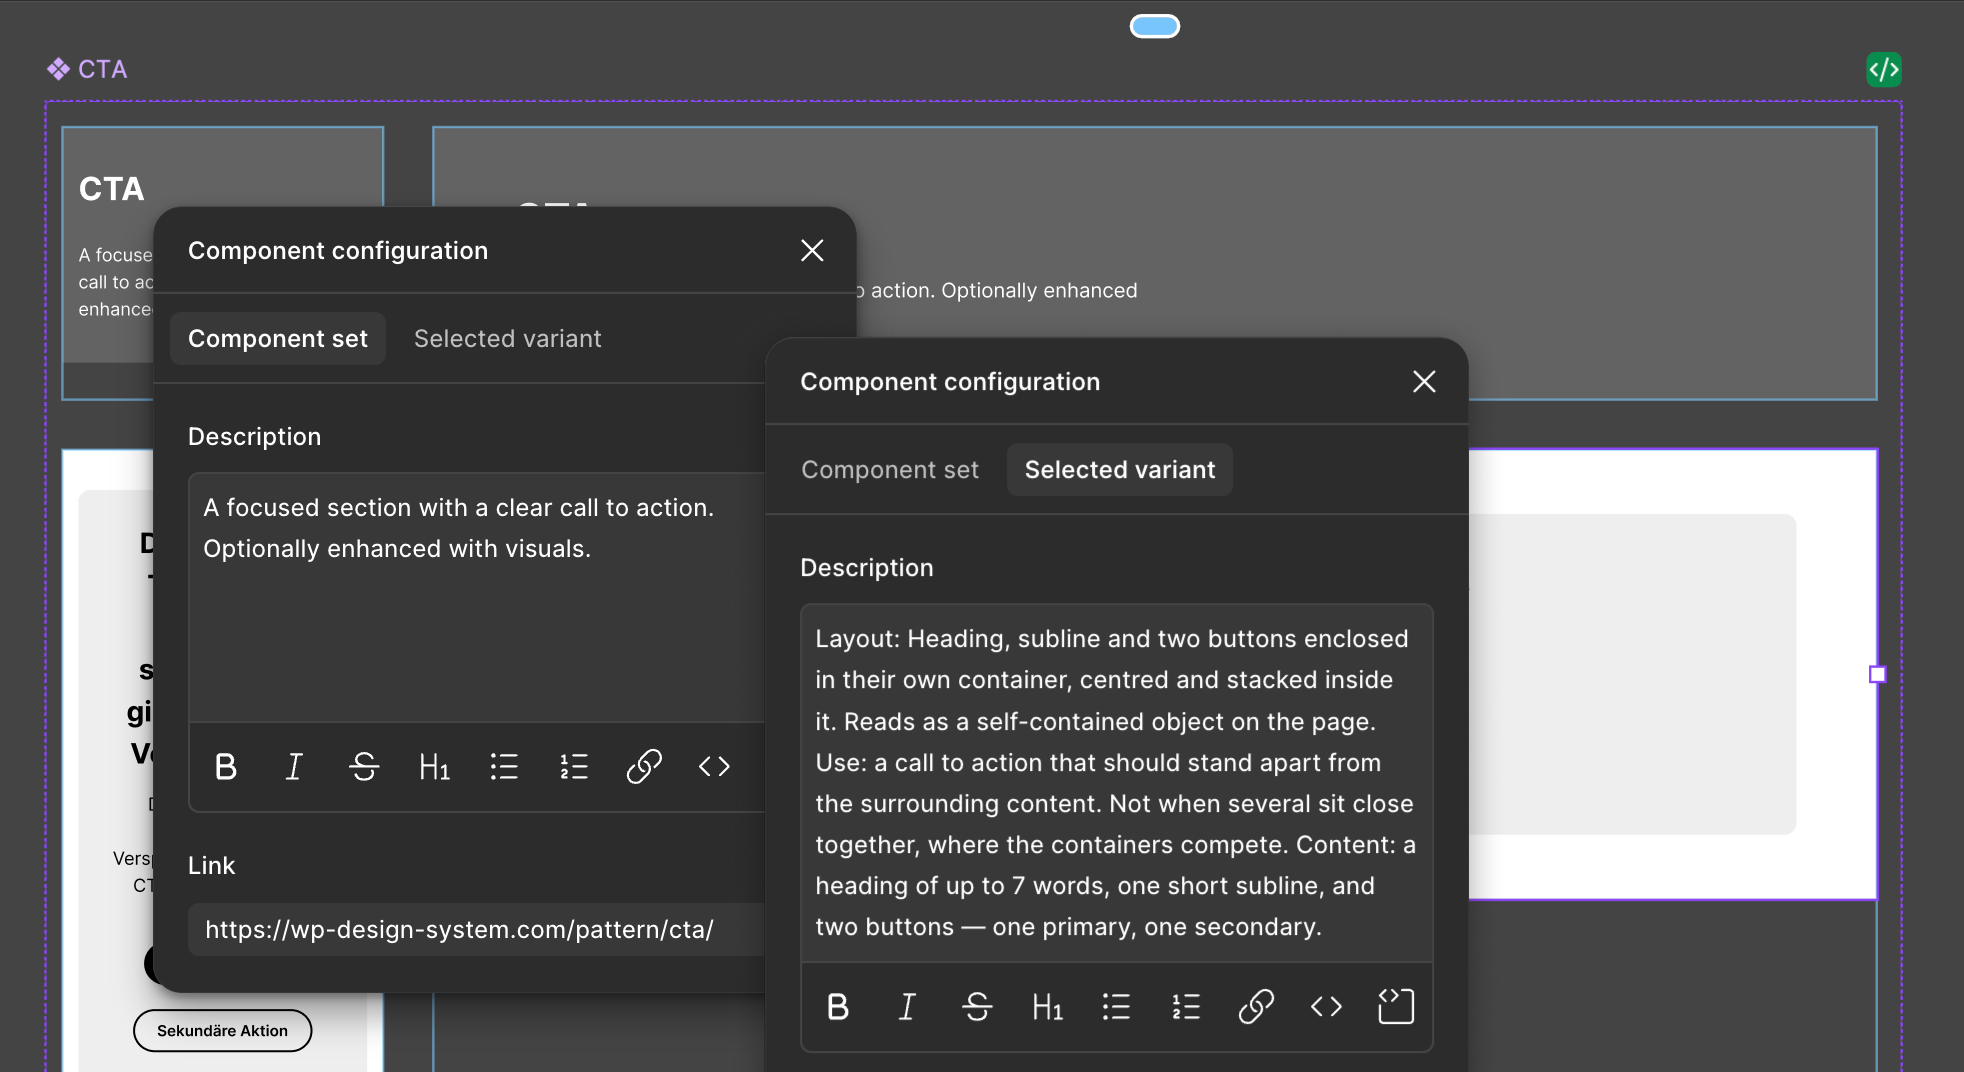
Das bedeutet konkret: Jede Komponente hat einen Namen und eine ausführliche Beschreibung. Diese Beschreibung erklärt den Zweck der Komponente, in welchen Situationen sie eingesetzt wird, was vermieden werden sollte und welche Rahmenbedingungen gelten. Alles, was einem Design-Team konzeptionell im Kopf schlummert, muss verschriftlicht werden. Dokumentiert wird dies z.B. in der Beschreibung der Komponenten oder, noch feiner, in der Beschreibung einzelner Varianten.
Ist das erfüllt, könnt ihr euch den Ablauf so vorstellen: Ihr nutzt den Agenten in Figma (Design Agent) oder verbindet ein externes KI-Tool eurer Wahl mit eurer Datei via MCP. Anschließend formuliert ihr euren Konzeptionswunsch als Prompt, zum Beispiel sinngemäß »Erstelle eine neue Landingpage mit folgenden Zielen …« oder »Entwirf eine Smartphone-App für die Steuerung unsere Maschine XY mit folgenden Funktionen …«. Weil die Bibliothek alle nötigen Informationen bereithält, entstehen daraus Entwürfe in sehr guter Qualität, etwa ein klickbarer Prototyp oder einzelne Screens.
Von Design zu Code
Der zweite große Anwendungsfall ist die Überführung des Designs in Code. Einerseits sollen so native Prototypen hergestellt werden, die im Browser laufen und leicht im Code angepasst werden können, andererseits soll tatsächlich der produktionsreife Code einer Website oder Applikation entstehen.
In beiden Fällen ist es enorm wichtig, dass die Ergebnisse erwartbar und konsistent sind. Die KI darf sich bei der Umsetzung eines Buttons nicht beim ersten Mal so und beim nächsten Mal anders entscheiden. Produktionsreif bedeutet vor allem, dass die Qualität den Anforderungen entspricht.
Die Code-Bibliothek soll neu aufgebaut werden
Wenn bereits eine Design-Bibliothek in Figma existiert, und die passende Code-Bibliothek daraus abgeleitet aufgebaut werden soll, muss die Vorlage nahezu perfekt sein. Sie muss alle Figma-Standardanforderungen an Bibliotheken erfüllen wie z.B. ein konsequent verwendetes Auto-Layout, Variablen für alles und eine saubere Organisation nach Atomic Design mit Komponenten und Varianten. Verschiedene Tools und Linter helfen dabei, Fehler zu erkennen und zu beheben.
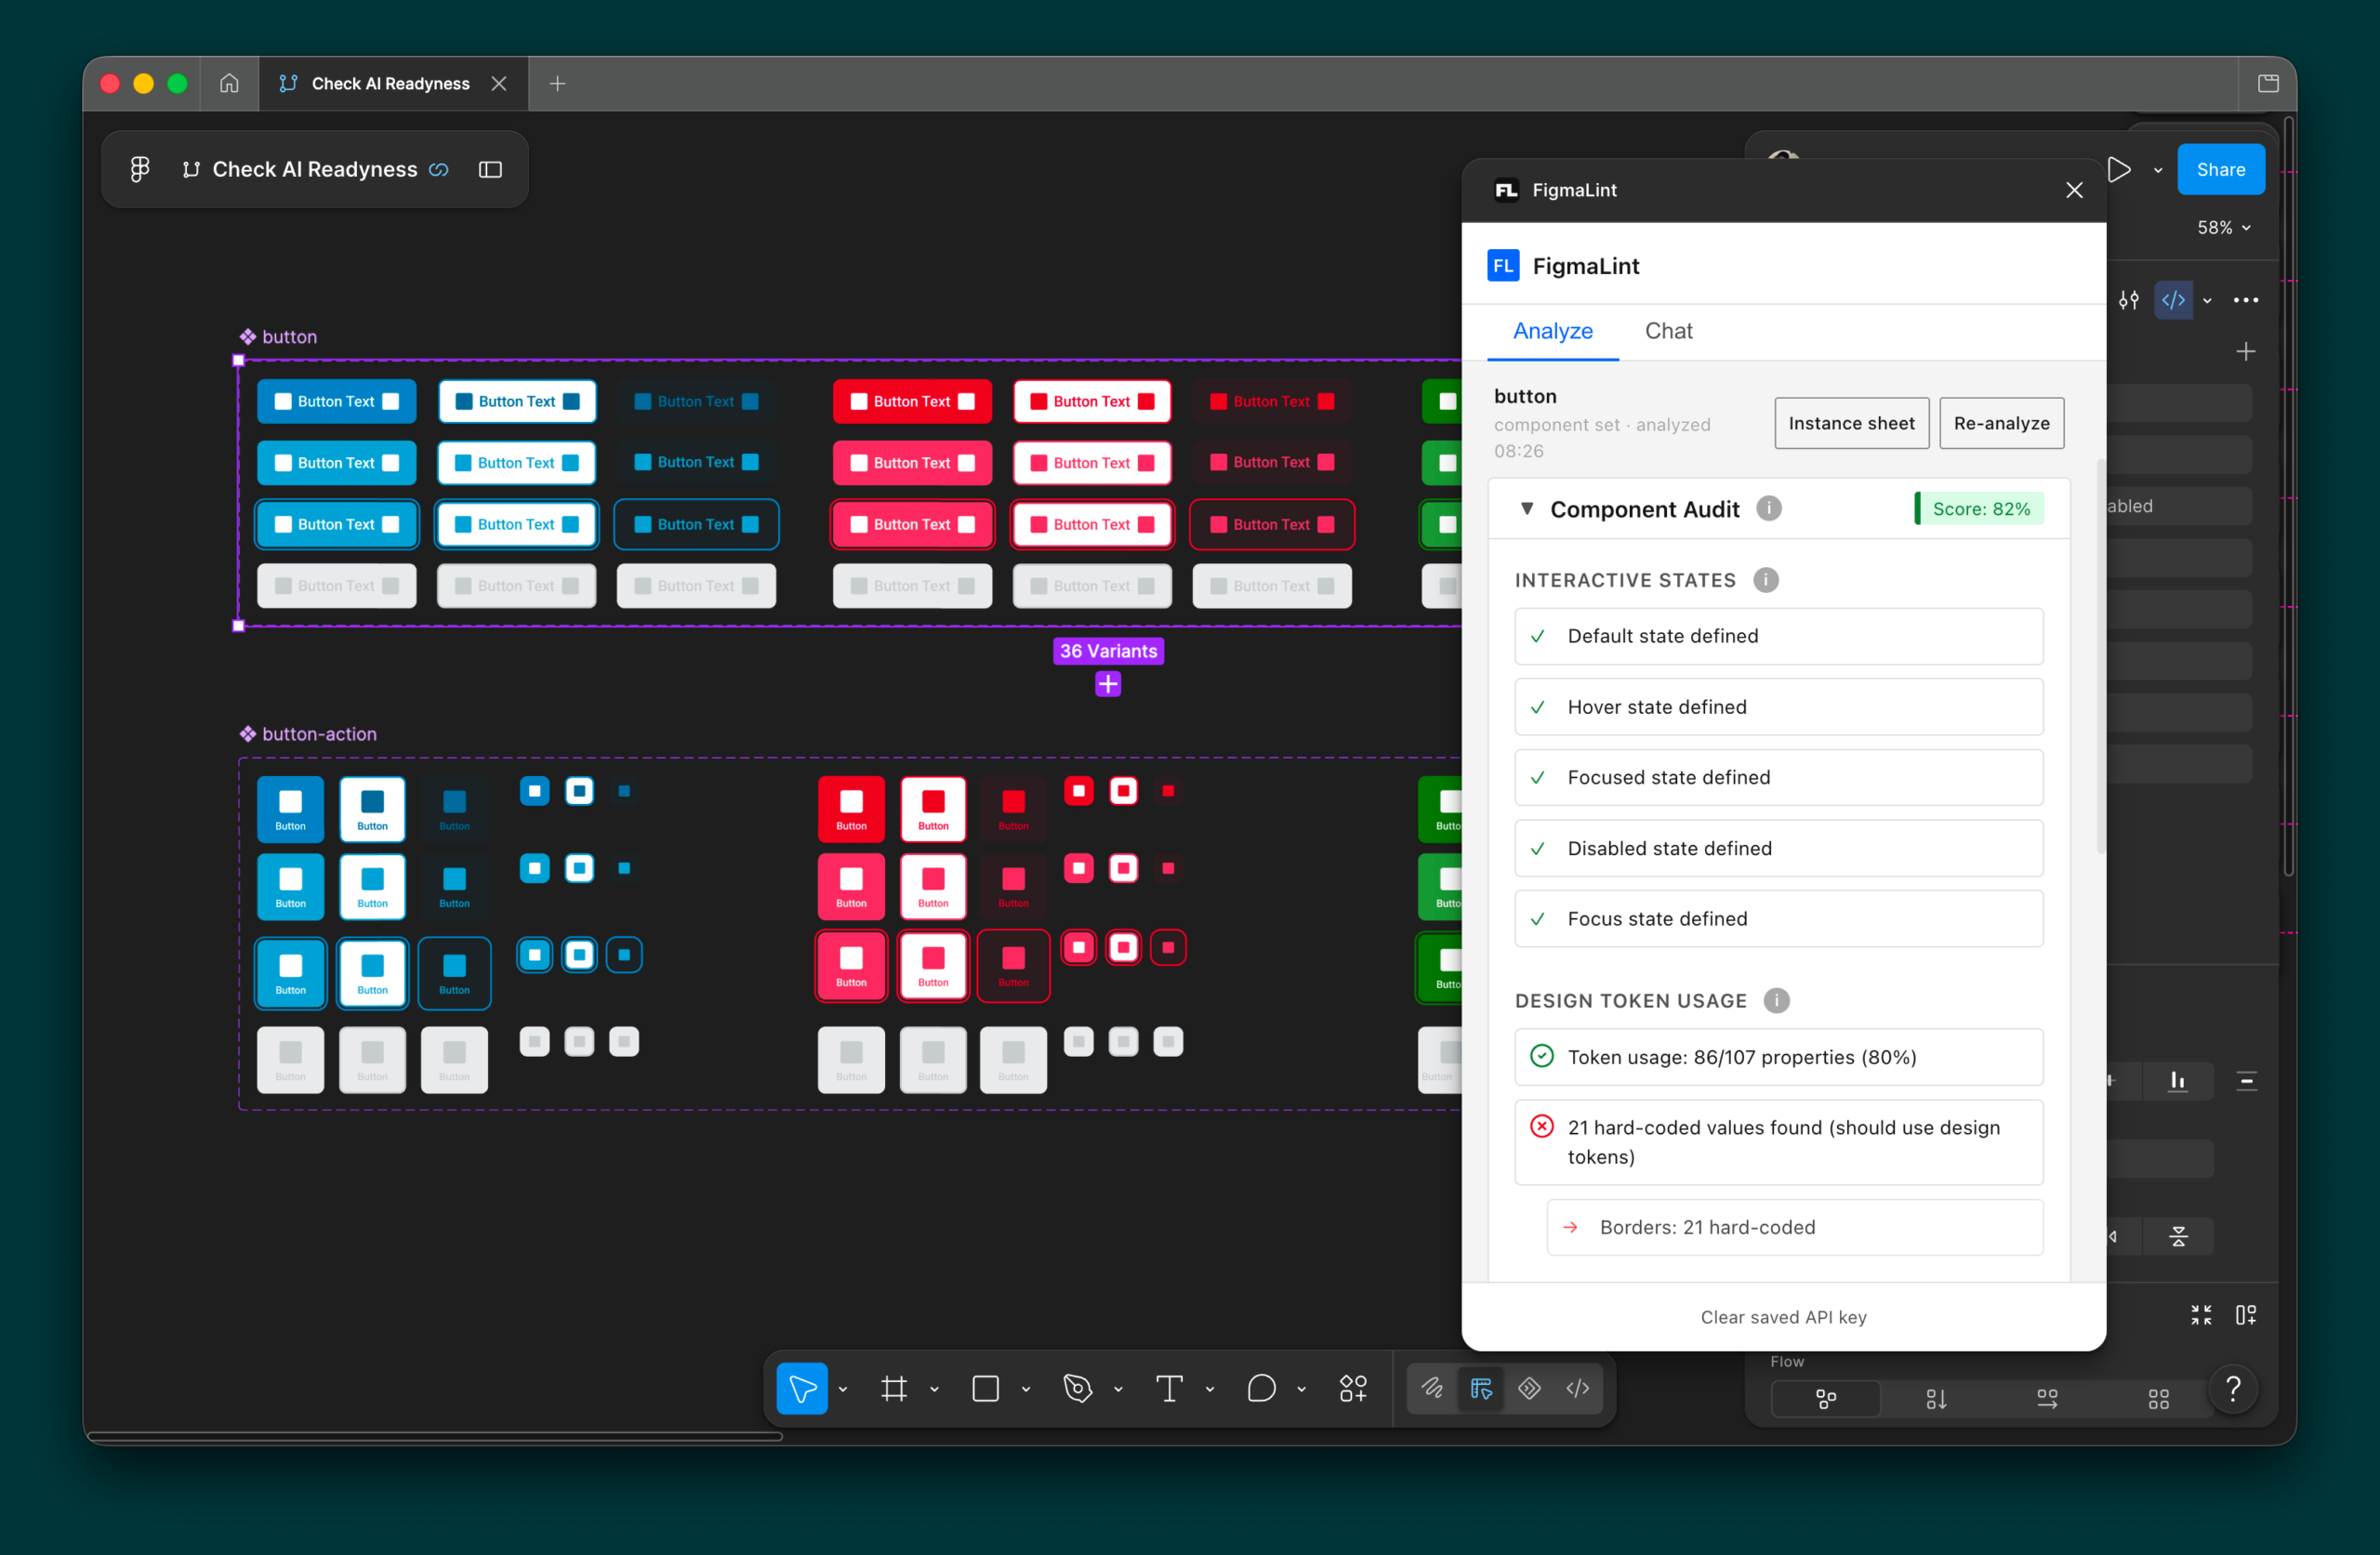
Der Anspruch muss sehr hoch sein. Besonders bei den Design Tokens, also den Figma-Variablen, muss die Umsetzung exakt stimmen, damit am Ende sauberer Code in der gewünschten Syntax herauskommt. Wenn, wie zuvor bereits beschrieben, alle Komponenten mit detaillierten Beschreibungen ausgestattet sind, können auch Entscheidungen zur Barrierefreiheit besser getroffen werden. Denn dann geht es nicht nur darum, wie ein Element aussieht, sondern darum, wie und wofür es verwendet wird. Die KI kann folglich semantische Entscheidungen deutlich besser treffen.
Technisch verbindet ihr Figma über den MCP-Server mit eurem KI-Tool. Anschließend solltet ihr schrittweise vorgehen. Vermeidet es, die gesamte Figma-Datei in einem einzigen Prompt zu referenzieren, sondern arbeitet strukturiert und schrittweise. Zuerst werden die Variablen ausgelesen und die Variablen-Struktur angelegt, idealerweise abstrahiert über ein offenes, JSON-basiertes Token-Format. Anschließend arbeitet ihr euch entlang des Atomic Design-Ansatz von klein nach groß durch die Bibliothek: erst die einzelnen Atome, dann die daraus zusammengesetzten Moleküle, dann die Organismen, also größere Elemente wie wiederkehrende Sinnabschnitte (Pattern, Module). Im letzten Schritt folgen Templates und schließlich vielleicht sogar Flows. Dieses schrittweise, aufeinander aufbauende Vorgehen spart euch viele Tokens, führt zu konsistenteren Ergebnissen und ergibt ein sauber strukturiertes System.
Es gibt bereits eine Code-Bibliothek
Wenn neben der Figma-Bibliothek bereits eine Code-Bibliothek existiert, deren Komponenten in einem Repository o.ä, liegen, kommt das Figma-Feature »Code Connect« ins Spiel. Mittels Code Connect verknüpft ihr eine Komponente aus der Figma-Bibliothek mit ihrem Gegenstück im Code.
Die Vorteile dieses Vorgehens sind deutlich spürbar. Setzt ein KI-Agent eine Ansicht um und stößt auf verknüpfte Komponenten, erfindet er deren Code nicht neu, sondern greift auf die bestehende Codebasis zu. Das spart Tokens und sorgt für noch konsistentere Ergebnisse. Diese Konstellation Figma-Bibliothek plus verknüpfte Code-Bibliothek, ist der Idealfall.
Code Connect ist Teil der höheren Figma-Lizenzmodelle und lässt sich auf zwei Arten nutzen. Die einfache Variante ist die Verwendung über die Figma-Benutzeroberfläche (Code Connect UI). Hier verbindet ihr Komponenten per Klick und könnt der Verbindung zusätzliche Notizen für die KI mitgeben. Die zweite Variante läuft über die Kommandozeile und integriert Code Connect direkt in die Codebasis (Code Connect CLI). Neben den eigentlichen Code-Dateien liegen dann zusätzliche Dateien, die festhalten, welche Figma-Komponente zu welcher Code-Komponente gehört. Dabei lässt sich sehr differenziert abbilden, welche Eigenschaften und States im Code welchen Varianten im Design entsprechen. Das ist aufwendig, weshalb Figma für diesen Fall unter anderem einen Skill für die KI bereitstellt.
Wenn ihr eine gut verknüpfte Code-Bibliothek hat, könnte ihr theoretisch Qualität in der Figma-Datei einsparen, weil der Agent die Details dort im Idealfall gar nicht mehr interpretieren muss. Als Empfehlung möchten wir das aber nicht verstanden wissen, denn eine saubere Design-Bibliothek zahlt an vielen anderen Stellen auf die Qualität ein.
Die Design-Bibliothek soll aus dem Code abgeleitet werden
Seltener, in der Praxis aber durchaus sinnvoll, ist die umgekehrte Richtung. Frontend-affine Teams haben häufig bereits eine Code-Bibliothek in sehr guter Qualität, aber noch keine gepflegte Figma-Bibliothek. Um diese automatisch zu erzeugen, kann der Code über den MCP-Server ausgelesen und daraus die Design-Bibliothek in Figma abgeleitet werden. Variablen und Komponenten werden dann in Figma automatisiert erzeugt.
Weil der Code oft die verlässlichere und höherwertige Quelle ist, entsteht so eine Design-Bibliothek, die sauber zum bestehenden Code passt. Wir haben das in mehreren Projekten umgesetzt, unter anderem bei unserem eigenen Design System für WordPress-Projekte.
Auch bei diesem Setup sollte schrittweise vorgegangen werden: Zunächst die Variablen, dann der Rest nach Atomic Design. Da im Browser mitunter CSS-Features verwendet wurden, die Figma nicht abbilden kann, müssen kleinere Abstriche in Kauf genommen werden.
Die strategische Frage: Wo liegt das Original?
Sobald Bibliotheken in Design und Code existieren, stellt sich die klassische Frage: Wo liegt die sog. »Single Source of Truth« – also das Original? Habt ihr eine Komponente erst im Design entworfen und den Code daraus abgeleitet, oder umgekehrt? Und wenn ihr etwas ändert, an welcher Stelle macht ihr das zuerst, und wo muss es nachgezogen werden? Dieselbe Frage betrifft die Design Tokens, also ob die Variablen in Figma oder im Code das Original sind, und ebenso die Dokumentation, ob ihr sie in Markdown-Dateien im Repository oder in den Figma-Komponenten pflegt.
Durch KI können sogenannte bidirektionale Workflows eingerichtet werden, wodurch diese Frage an Schärfe verliert. Änderungen lassen sich so synchronisieren, dass sie an einer Stelle vorgenommen und automatisch an allen anderen nachgezogen werden. Ändert ihr eine Variable im Code, erkennt der Agent das und trägt sie in Figma nach. Ändert ihr sie in Figma, geschieht dasselbe umgekehrt. Aus einem einzigen Original wird ein Netz aus synchronisierten Originalen in verschiedenen Umgebungen.
Trotzdem haben wir eine klare Empfehlung, die wir auch selbst beherzigen. Versucht, möglichst wenige Abhängigkeiten zu einzelnen Plattformen aufzubauen. Praktisch bedeutet das, die Variablen im Standard für Design Tokens zu definieren, die Komponenten-Beschreibungen in Markdown-Dateien im eigenen Projekt zu dokumentieren und Code Connect über die Kommandozeile direkt ins Repository zu integrieren. So habt ihr versionierbare Dateien in Standardformaten, auf die ihr jederzeit zugreifen könnt und die euch niemand wegnehmen kann.
Der scheinbare Nachteil, dass Beschreibungen in Markdown-Dateien in Figma zunächst nicht sichtbar sind, lässt sich mit KI leicht auflösen. Ihr weist den Agenten an, das Komponenten-Verzeichnis zu lesen und die Beschreibungen über die MCP-Schnittstelle in die passenden Figma-Komponenten einzutragen. Auch das lässt sich bidirektional einrichten, sodass Beschreibungen immer aktuell sind.
Wo die Anweisungen hinterlegt werden
Egal ob aus einer Idee ein Prototyp oder aus einem fertigen Design sauberer Code entstehen soll, ihr müsst entscheiden, wo ihr die Anweisungen hinterlegen möchtet, die den Prozess steuern und für konsistente Ergebnisse sorgen. Was genau ihr mit Figma, Code und KI macht ist dabei zweitrangig. Entscheidend ist, dass die KI bei gleicher Aufgabe immer vergleichbar arbeiten muss.
Ihr könnt Vorgaben auf verschiedenen Ebenen festlegen, zum Beispiel zentral für die gesamte Organisation, pro Projekt oder individuell pro User.
Dafür habt ihr zwei Wege. Entweder legt ihr die Vorgaben direkt beim KI-Anbieter fest, etwa über das Web-Interface. Oder ihr steuert sie auf Dateiebene, meist im Markdown-Format, über Instruktionsdateien wie eine claude.md oder über sogenannte Skills. Auch diese Dateien könnt ihr flexibel platzieren, zum Beispiel auf dem eigenen Rechner, im Repository eines Projekts oder verbindlich für die ganze Organisation.
Welcher Weg der beste ist, hängt davon ab, wie das Team arbeitet und womit es die verlässlichsten Ergebnisse erzielt. Unsere Empfehlung geht in dieselbe Richtung wie zuvor bei der Dokumentation der Komponenten. Wir möchten möglichst geringe Abhängigkeit von einzelnen Plattformanbietern. In der Praxis bedeutet das, Anweisungen liegen eher in Markdown-Dateien und Skills. So lassen sie sich bei Bedarf zu einem anderen LLM-Anbieter umziehen.
Fazit
Die einzelnen Bausteine greifen ineinander. Am Zentrum steht in fast allen Szenarien eine saubere, gut beschriebene Komponenten-Bibliothek. Auf ihr baut die KI-Unterstützung im Design auf, auf ihr baut die Überführung in produktionsreifen Code auf, und sie ist auch die Grundlage dafür, Design und Code dauerhaft synchron zu halten. Die eigentliche Investition liegt weniger in Tools und Anbietern als in der Qualität und Dokumentation des Design Systems. Wenn ihr hier sauber arbeitet und die eigenen Daten in offenen Standards definiert, schafft ihr eine nachhaltige Grundlage für schnelle, konsistente und verlässliche Workflows, ohne euch von einer einzelnen Plattform abhängig zu machen. Selbst ohne KI hat diese Dokumentation einen großen Mehrwert.